実行の制御
状態
| 状態 | 意味 |
|---|---|
SCHEDULED | 初回とリトライの実行待ち |
QUEUED | 実行対象となり、performerの開始前 |
RUNNING | performerの実行中 |
COMPLETED | 成功。終了状態の1つで、他の状態への遷移なし |
FAILED | 試行回数の上限までの失敗。手動のリトライでSCHEDULEDに遷移 |
CANCELLED | 取り消し済み。終了状態の1つで、他の状態への遷移なし |
STALLED | 結果が報告されないままの停止。手動のリトライに限りSCHEDULEDに遷移 |
attemptsは、終了した試行の回数です。SCHEDULEDのジョブは、attemptsが0の場合は初回の実行待ち、1以上の場合はリトライ待ちです。FAILEDとSTALLEDのジョブは、ダッシュボードまたはREST APIから手動でリトライしてください。
遷移
SCHEDULEDのジョブを取り消すと、直ちにCANCELLEDに遷移します。QUEUEDとRUNNINGのジョブは、期限を過ぎた場合か、実行中の取り消しが確定した場合に、CANCELLEDに遷移します。
リトライ
リトライの回数の上限はmaxAttemptsで、間隔はbackoffで設定します。maxAttemptsには、1以上の整数を指定してください。backoffは、固定間隔のfixedと指数バックオフのexponentialのどちらかの形式で指定します。
INFO
wrangler.jsoncのmax_retriesはQueuesの設定です。Tsumugiのリトライには影響しません。
バックオフ
既定は、次の指数バックオフです。
{ kind: 'exponential', baseMs: 1_000, factor: 2, maxMs: 3_600_000, jitter: true }
固定間隔にする場合は、kindにfixedを指定してください。
await tsumugi.enqueue(env, {
  binding: 'MAIL',
  payload,
  backoff: { kind: 'fixed', delayMs: 30_000, jitter: true },
});
jitter: trueを指定すると、同時に失敗した多数のジョブの再試行時刻が分散されます。
performer側から再試行の可否と次の再試行の時刻を指定する方法は、再試行の指定を参照してください。
実行保証
guaranteeは、at-least-once(既定)とat-most-onceのいずれかです。
結果が報告されないジョブの動作は、選択した値により異なります。
| 保証 | 結果が報告されない場合の動作 |
|---|---|
at-least-once(既定) | SCHEDULEDとしての再投入 |
at-most-once | 再投入なしのSTALLED。再実行は手動のリトライに限定 |
await tsumugi.enqueue(env, {
  binding: 'CHARGE',
  payload,
  guarantee: 'at-most-once',
});
at-most-onceのジョブは、二重に実行されません。
その代わり、実行を開始するまでの時間は、at-least-onceより長くなります。
タイムアウトと無応答
timeoutMsを過ぎた試行は、失敗として扱われます。
試行のエラーには、TsumugiTimeoutError(job timed out (<jobId>, <timeoutMs>ms))が記録されます。
タイムアウト後も、performerの実行は停止されません。
処理を中断する方法は、タイムアウトによる中断を参照してください。
QUEUEDまたはRUNNINGのジョブは、実行開始(または最後のheartbeat)からtimeoutMsとreaperGraceMs(既定30秒)を過ぎても試行結果が記録されない場合に無応答と判定されます。at-most-onceのジョブは、試行回数に関係なくSTALLEDへ遷移します。at-least-onceのジョブは、試行回数が上限に達していなければ再投入され、達していればFAILEDに遷移します。
実行中の取り消し
QUEUEDとRUNNINGのジョブを取り消すと、performerへの取り消しの要求が記録されます。
取り消しは、ダッシュボードかPOST /api/jobs/:id/cancelで実行します。
このエンドポイントのレスポンスには、requested: trueが含まれます。
performerは、ctx.heartbeat()の戻り値cancelRequestedで要求を確認します。
処理を中断する場合は、例外をthrowして終了してください。
要求後に失敗した試行はリトライされず、ジョブはCANCELLEDに遷移します。
const { cancelRequested } = await ctx.heartbeat(progress);
if (cancelRequested) throw new Error('cancelled');
要求より先に成功が報告された場合は、ジョブはCOMPLETEDのままとなり、結果も保存されます。
要求からreaperGraceMs(既定30秒)が過ぎても結果が報告されない場合は、ジョブがCANCELLEDに遷移します。
performerの実行は停止されないため、要求を確認しないperformerは実行を続けます。CANCELLEDに遷移した後の報告は、破棄されます。
リトライ待ちのジョブは、再投入されずCANCELLEDへ遷移します。
実行前のat-most-onceのジョブも、実行されずCANCELLEDへ遷移します。
取り消しを要求済みのジョブにrescheduleを要求すると、REST APIは409で応答します。heartbeatを呼ばないperformerは、要求を確認しません。
実行量の制限
bindingごとに、4つの設定で実行量を制限します。
| 設定 | 既定 | 内容 |
|---|---|---|
concurrency | 100 | 同時に実行するジョブ数の上限 |
rate | null | 一定時間あたりに実行するジョブ数の上限。nullは制限なし |
perKeyConcurrency | 1 | concurrencyKeyごとの同時実行数の上限 |
perKeyRate | null | concurrencyKeyごとの一定時間あたりの実行数の上限。nullは制限なし |
const tsumugi = defineTsumugi({
  performers,
  bindings: {
    MAIL: {
      policy: {
        concurrency: 20,
        rate: { tokens: 100, intervalMs: 60_000 },
        perKeyConcurrency: 1,
        perKeyRate: { tokens: 10, intervalMs: 60_000 },
      },
    },
  },
});
perKeyRateは、すべてのキーに同じ値で適用されます。
キーごとに異なる値を設定する項目は、用意されていません。concurrencyKeyがnullのジョブには、perKeyConcurrencyとperKeyRateが適用されません。
実行されない原因の確認
投入したジョブが実行されない場合は、GET /api/diagnosticsのレスポンスで、実行を制限している設定を確認してください。
レスポンスは、一時停止、同時実行数、レートのどれが原因かを示します。
実行時の変更
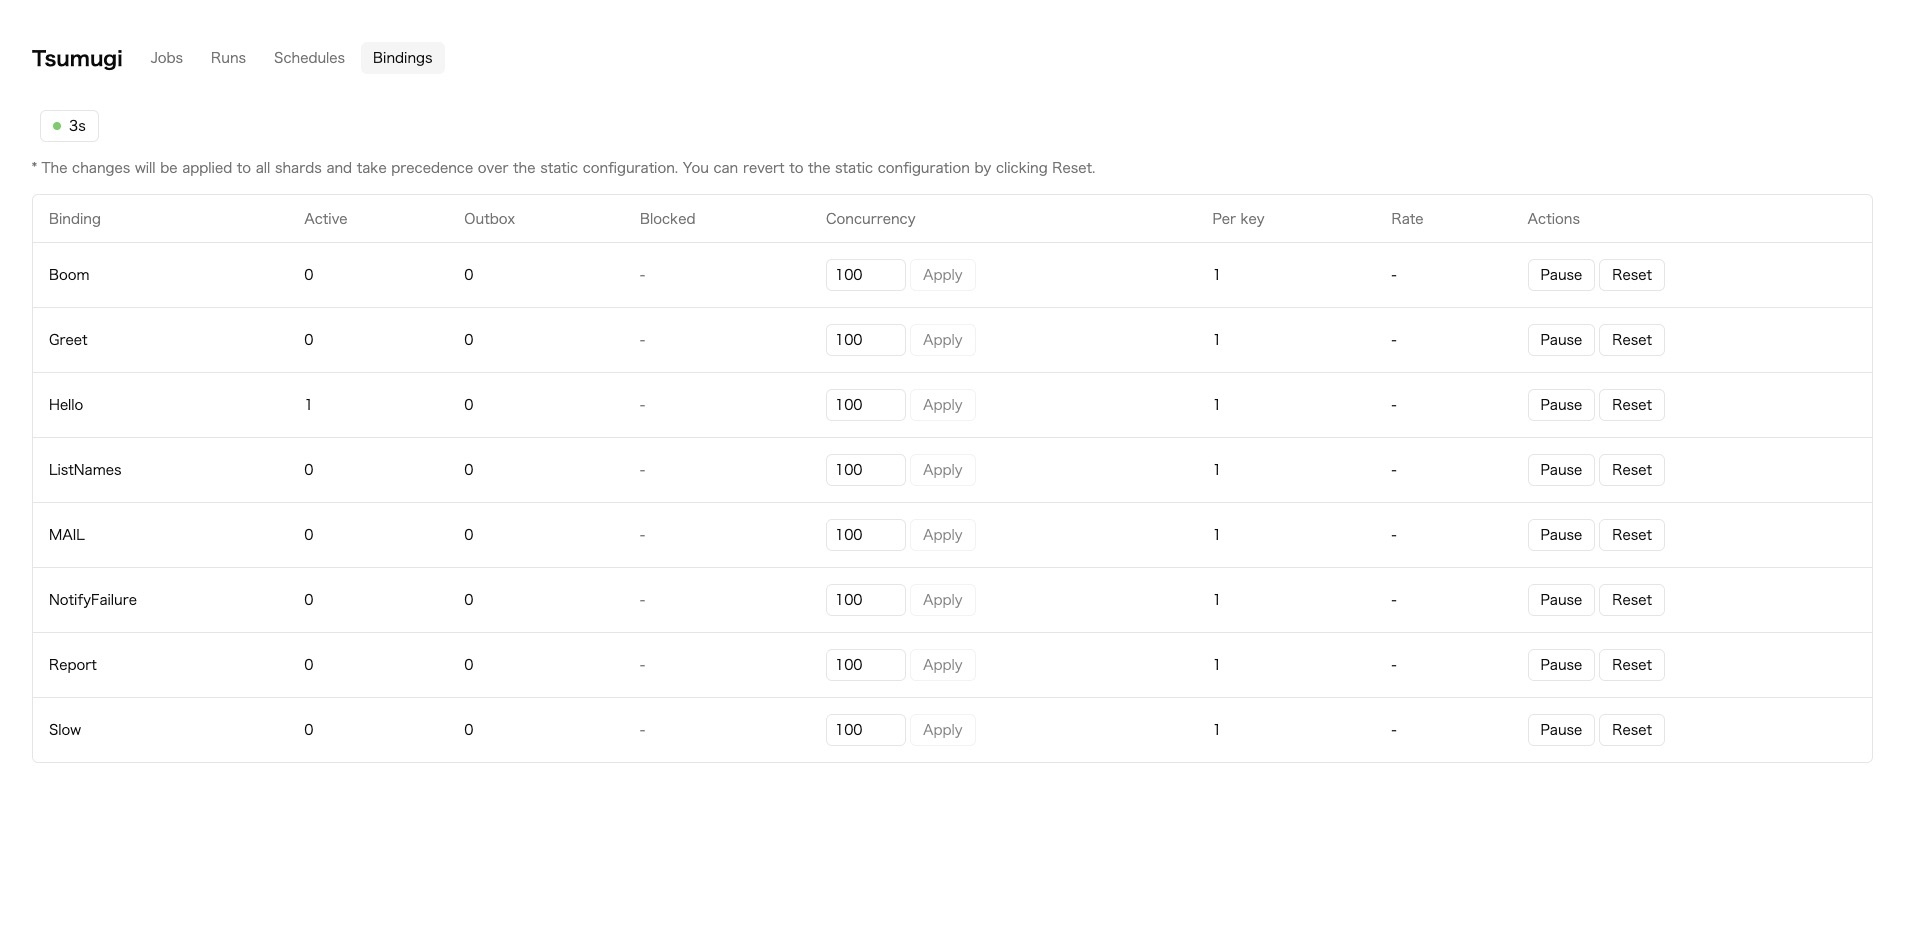
ダッシュボードのbindingsタブでは、同時実行数の変更と投入の一時停止を操作します。
変更はデプロイを必要とせず、bindingのすべてのshardに適用されます。
この操作は、POST /api/bindings/:binding/policyの呼び出しと同様です。
curl -X POST -H "authorization: Bearer $TOKEN" -H 'content-type: application/json' \
  -d '{"paused": true}' https://example.com/api/bindings/MAIL/policy
再開後は、一時停止前から待機していた優先度の低いジョブが、後から投入された優先度の高いジョブより先に実行されることがあります。
コードから変更する場合は、tsumugi.shardForで取得したstubのconfigureを呼び出してください。configureは、policyで実行量の設定を、sweepAfterMsとfailedRetentionMsで保持期間を変更します。
await tsumugi.shardFor(env, 'MAIL').configure({ policy: { concurrency: 5 } });
実行時に変更した設定は、bindingsの設定より優先されます。
その後は、bindingsの設定は適用されません。bindingsの設定に戻すには、POST /api/bindings/:binding/policy/resetを呼び出してください。
あるいは、configureで元の内容を再度指定します。
エージング
優先度の高いジョブが投入され続けると、優先度の低いジョブがいつまでも実行されません。
これを防ぐために、待ち時間に応じて実効優先度が上がります。
この動作をエージングと呼び、既定で適用されます。
上がる間隔はagingIntervalMsで、既定値は60秒です。nullを指定すると、エージングは適用されず、優先度の順序どおりにジョブが実行されます。
shard
shardは、bindingのジョブを分割して管理する単位です。
既定のshard数は1です。
bindings: {
  MAIL: { shards: 4 },
}
shard数を2以上にすると、partitionKeyが必須になり、省略すると例外が発生します。concurrencyKeyとuniqueKeyによる制御の範囲は、shard数によって異なります。
shard数が1の場合、binding内のすべてのジョブが対象です。
2以上の場合、partitionKeyで選ばれる同じshardのジョブに限られます。
concurrencyKeyまたはuniqueKeyを使用する場合は、partitionKeyにも同じキーを指定してください。
異なる値を設定してもエラーにはなりませんが、同じキーを持つジョブが別々のshardに割り当てられる可能性があります。
その結果、同時実行や重複生成が発生することがあります。
保持期間
終了したジョブは、一定期間が経過すると削除されます。
| 対象 | 設定 | 既定 |
|---|---|---|
COMPLETED / CANCELLED | sweepAfterMs | 5分 |
FAILED / STALLED | failedRetentionMs | 7日 |
削除済みのジョブは、リトライできません。
両方の設定は、bindingsでbindingごとに指定します。
const tsumugi = defineTsumugi({
  performers,
  bindings: {
    MAIL: { sweepAfterMs: 60 * 60 * 1000, failedRetentionMs: 14 * 24 * 60 * 60 * 1000 },
  },
});
ダッシュボードとREST APIの一覧に表示する期間は、保持期間とは別にretentionで設定します。
cronトリガーを設定すると、期間を過ぎた終了済みのジョブとRunが一覧から削除されます。
詳細はSweepOptionsを参照してください。
既定では2つの期間が一致します。
そのため、一覧に表示されているFAILEDとSTALLEDのジョブは、リトライの対象です。
一方の期間だけを変更した場合は、一覧に表示されているジョブでも、リトライの要求に対してREST APIが410で応答する可能性があります。
失敗の通知
onFailureに通知先のbinding名を指定すると、FAILEDとSTALLEDのジョブが、指定したperformerに通知されます。FAILEDは、試行回数の上限まで失敗したジョブです。STALLEDは、結果が報告されないまま停止したジョブです。
const tsumugi = defineTsumugi({
  performers,
  onFailure: 'NotifyFailure',
});
通知先のperformerは、FailureNoticeを引数として受け取ります。
import { Performer } from 'tsumugi/performer';
import type { FailureNotice } from 'tsumugi';

export class NotifyFailure extends Performer<FailureNotice, void, {}, Env> {
  async perform(notice: FailureNotice): Promise<void> {
    const res = await fetch(this.env.SLACK_WEBHOOK, {
      method: 'POST',
      body: JSON.stringify({ text: `${notice.binding} が失敗しました: ${notice.error}` }),
    });
    if (!res.ok) throw new Error(`notification failed: ${res.status}`);
  }
}
FailureNotice
| 名前 | 内容 |
|---|---|
jobId | 失敗したジョブのID |
binding | 失敗したジョブのbinding |
state | FAILEDまたはSTALLED |
attempts | 実行した回数 |
maxAttempts | 試行回数の上限 |
error | 最後の試行のエラー。記録なしの場合はnull |
runId | 投入元のRun。単独で投入したジョブはnull |
nodeId | 投入元のノード。単独で投入したジョブはnull |
failedAt | 失敗した時刻。epochミリ秒 |
すべてのbindingのジョブが通知の対象です。
通知は1件のジョブとして実行されます。
通知ジョブが失敗した場合、そのジョブは一覧に表示されます。
通知ジョブも他のジョブと同様にリトライの対象です。
通知先のbinding自身のジョブの失敗は通知されません。onFailureを指定する前に失敗したジョブは対象外です。
終了の通知
onSettledを指定すると、失敗に限らず、終了したジョブが指定したperformerに通知されます。
通知する状態はstatesに指定し、COMPLETED, FAILED, CANCELLED, STALLEDから選びます。statesは必須です。空の配列や不正な状態を指定すると、defineTsumugiで例外が発生します。
const tsumugi = defineTsumugi({
  performers,
  onSettled: {
    binding: 'NotifySettled',
    states: ['COMPLETED', 'FAILED', 'CANCELLED', 'STALLED'],
  },
});
COMPLETEDを含めると、完了したジョブと同じ数の通知ジョブが投入されます。
ジョブの件数を確認してから指定してください。
通知先のperformerは、SettledNoticeを引数として受け取ります。
SettledNotice
| 名前 | 内容 |
|---|---|
jobId | 終了したジョブのID |
binding | 終了したジョブのbinding |
state | 終了時の状態 |
attempts | 実行した回数 |
maxAttempts | 試行回数の上限 |
error | 最後の試行のエラー。失敗以外の終了と記録なしの場合はnull |
result | performの戻り値。COMPLETED以外と保存上限超過の場合はnull |
runId | 投入元のRun。単独で投入したジョブはnull |
nodeId | 投入元のノード。単独で投入したジョブはnull |
settledAt | 終了した時刻。epochミリ秒 |
通知先のbinding自身のジョブと、onFailureの通知先のbindingのジョブは、通知されません。onFailureと同時に指定した場合、statesに含めたFAILEDとSTALLEDは、両方の通知先に通知されます。onSettledを指定する前に終了したジョブは、対象外です。
投入時の既定値
onEnqueueを指定すると、ジョブの投入ごとにonEnqueueが呼び出され、その戻り値が実行オプションの既定値として使用されます。
呼び出し側で指定された値は常に優先され、既定値はオプションが明示されていない場合にのみ適用されます。
const tsumugi = defineTsumugi({
  performers,
  onEnqueue: (input) => (input.binding === 'SlowJob' ? { timeoutMs: 300_000 } : undefined),
});
既定値にできる実行オプションは、traceparent, priority, maxAttempts, backoff, timeoutMs, guarantee, delayMs, runAt, expiresAt, expiresInMs, concurrencyKeyです。binding, payload, uniqueKey, uniqueForMs, partitionKeyは、対象外です。
onFailureとonSettledの通知ジョブには、onEnqueueが適用されません。
別Workerから投入するジョブにも適用する場合は、createClientに同じ関数を渡してください。
公開日: 最終更新: